字符串匹配的KMP算法
编者注:本文为历史博文归档;涉及 JDK、框架与工具链版本请以当前官方文档为准。引用外链图片可能失效,阅读时请注意时效性。
字符串匹配的 KMP 算法
字符串匹配(String Matching)是计算机的基本任务之一。
举例来说,有一个字符串 "BBC ABCDAB ABCDABCDABDE",我想知道,里面是否包含另一个字符串 "ABCDABD"?
许多算法可以完成这个任务,Knuth-Morris-Pratt 算法(简称 KMP)是最常用的之一。它以三个发明者命名,起头的那个 K 就是著名科学家 Donald Knuth。
这种算法不太容易理解,网上有很多 解释,但读起来都很费劲。直到读到 Jake Boxer 的文章,我才真正理解这种算法。下面,我用自己的语言,试图写一篇比较好懂的 KMP 算法解释。
算法匹配过程
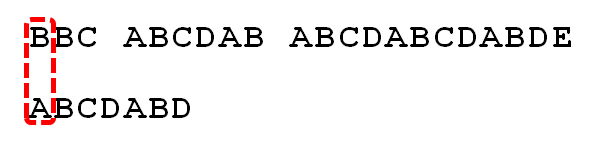
首先,字符串
"BBC ABCDAB ABCDABCDABDE"的第一个字符与搜索词"ABCDABD"的第一个字符进行比较。因为B与A不匹配,所以搜索词后移一位。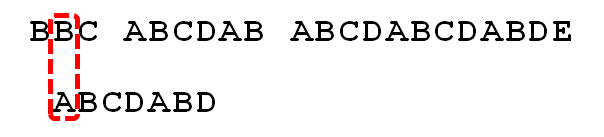
因为
B与A不匹配,搜索词再往后移。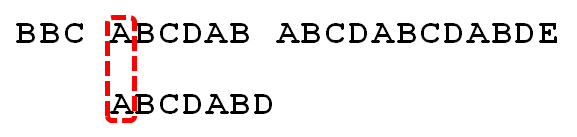
就这样,直到字符串有一个字符,与搜索词的第一个字符相同为止。
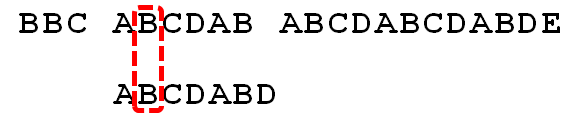
接着比较字符串和搜索词的下一个字符,还是相同。
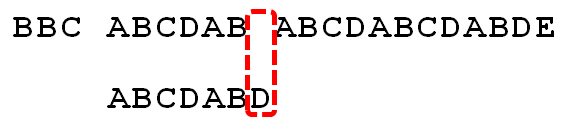
直到字符串有一个字符,与搜索词对应的字符不相同为止。
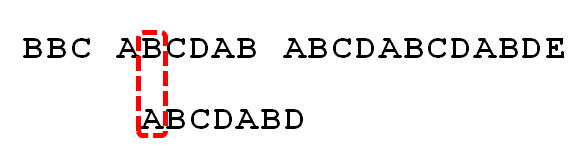
这时,最自然的反应是将搜索词整个后移一位,再从头逐个比较。这样做虽然可行,但是效率很差,因为你要把“搜索位置”移到已经比较过的位置,重比一遍。
一个基本事实是,当空格与
D不匹配时,你其实知道前面六个字符是"ABCDAB"。KMP 算法的想法是,设法利用这个已知信息,不要把“搜索位置”移回已经比较过的位置,继续把它向后移,这样就提高了效率。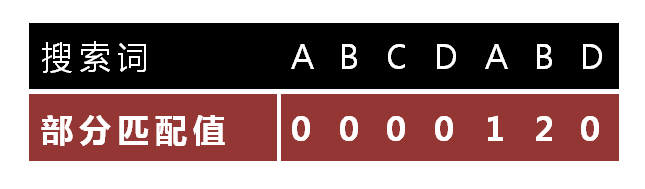
怎么做到这一点呢?可以针对搜索词,算出一张《部分匹配表》(Partial Match Table)。这张表是如何产生的,后面再介绍,这里只要会用就可以了。
已知空格与
D不匹配时,前面六个字符"ABCDAB"是匹配的。查表可知,最后一个匹配字符B对应的“部分匹配值”为 2,因此按照下面的公式算出向后移动的位数:移动位数 = 已匹配的字符数 - 对应的部分匹配值
因为
6 - 2等于 4,所以将搜索词向后移动 4 位。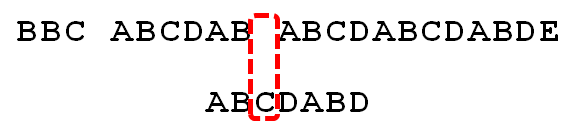
因为空格与
C不匹配,搜索词还要继续往后移。这时,已匹配的字符数为 2("AB"),对应的“部分匹配值”为 0。所以,移动位数 =2 - 0,结果为 2,于是将搜索词向后移 2 位。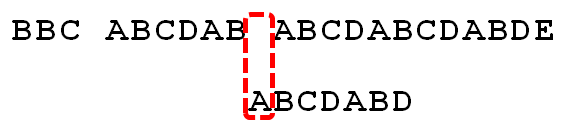
因为空格与
A不匹配,继续后移一位。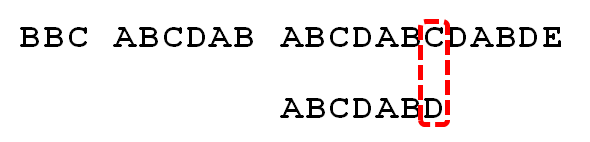
逐位比较,直到发现
C与D不匹配。于是,移动位数 =6 - 2,继续将搜索词向后移动 4 位。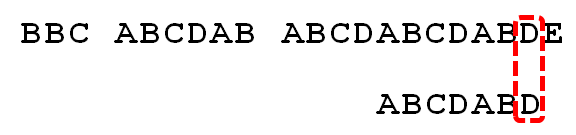
逐位比较,直到搜索词的最后一位,发现完全匹配,于是搜索完成。如果还要继续搜索(即找出全部匹配),移动位数 =
7 - 0,再将搜索词向后移动 7 位,这里就不再重复了。
部分匹配表的生成
下面介绍《部分匹配表》是如何产生的。
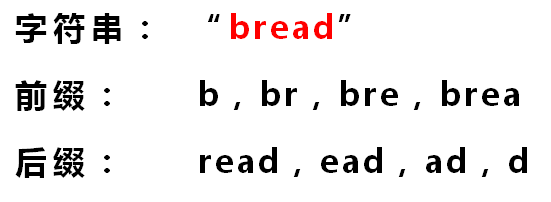
首先,要了解两个概念:“前缀”和“后缀”。
- 前缀:指除了最后一个字符以外,一个字符串的全部头部组合。
- 后缀:指除了第一个字符以外,一个字符串的全部尾部组合。
“部分匹配值”就是“前缀”和“后缀”的最长的共有元素的长度。以
"ABCDABD"为例:子串 前缀 后缀 共有元素 部分匹配值 "A" 空集 空集 无 0 "AB" [A] [B] 无 0 "ABC" [A, AB] [BC, C] 无 0 "ABCD" [A, AB, ABC] [BCD, CD, D] 无 0 "ABCDA" [A, AB, ABC, ABCD] [BCDA, CDA, DA, A] "A" 1 "ABCDAB" [A, AB, ABC, ABCD, ABCDA] [BCDAB, CDAB, DAB, AB, B] "AB" 2 "ABCDABD" [A, AB, ABC, ABCD, ABCDA, ABCDAB] [BCDABD, CDABD, DABD, ABD, BD, D] 无 0 “部分匹配”的实质是,有时候,字符串头部和尾部会有重复。比如,
"ABCDAB"之中有两个"AB",那么它的“部分匹配值”就是 2("AB"的长度)。搜索词移动的时候,第一个"AB"向后移动 4 位(字符串长度 - 部分匹配值),就可以来到第二个"AB"的位置。
说明:本文算法原理 timeless,但博文归档自 2013 年左右,具体实现细节请参考最新计算机算法教材或官方文档。
版权声明:本文为原创文章,版权归 戴老师的博客 所有,转载请联系博主获得授权。
本文地址:https://www.tushu.info/archives/zi-fu-chuan-pi-pei-de-kmp-suan-fa.html
如果对本文有什么问题或疑问都可以在评论区留言,我看到后会尽量解答。